Update di sini. Seseorang sebelumnya di thread ini mengatakan bahwa QuTS Hero 6.0 memberikan perbedaan, tetapi upaya pertama saya tidak berhasil (masih default ke CPU). Namun, dengan sedikit bantuan dari Google Gemini, saya akhirnya mendapatkan YAML yang bekerja untuk saya.
Hardware: QNAP TVS-h1688x
QuTS Hero: 6.0.0.3500
GPU: Nvidia RTX 3060 (12 GB VRAM)
Docker: Container Station
Tujuan saya adalah menjalankan Ollama di 1688x saya dengan front end OpenWebUI. Saya meminta Google Gemini untuk menulis YAML yang sesuai yang bisa berjalan di QNAP Container Station dengan mempertimbangkan RTX 3060. Ini adalah percobaan pertama dan ingat, versi ini TIDAK BERHASIL menggunakan GPU.
Again, the previous YAML failed to use the GPU. After asking Gemini to rework the issue, it came back with the following YAML that did work with the GPU: (I deleted the OpenWebUI YAML for redundancy since it didn’t change)
I have no idea if this will solve the issue with QTS 5.9.0, but it may be worth a shot. The big difference are the environment variables (OLLAMA_HOST and OLLAMA_KEEP_ALIVE).
Saya sendiri belum benar-benar mengalami masalah serupa seperti yang disebutkan di thread ini. Mungkin saya saja yang belum menyadarinya karena memang tidak selalu memakai open-web AI/ aplikasi ollama. Saya biarkan tetap berjalan saja dan biasanya model LLM akan dimatikan (unload), lalu saat saya pakai lagi nanti langsung diload kembali.
Saya menggunakan kartu Nvidia yang didukung untuk model NAS saya.
Kadang-kadang saya memang dapat OOM killer, tapi bisa diatasi dengan stop aplikasi lalu start ulang aplikasi. Tidak pernah harus mematikan NAS sepenuhnya.
Kartu GPU juga saya pakai bersama dengan aplikasi jellyfin dan immich.
File app compose untuk deploy
#4 CPU | 6144 MB RAM
services:
  open-webui:
    image: ghcr.io/open-webui/open-webui:cuda
    container_name: oi
    stdin_open: true
    tty: true
    pull_policy: always
    networks:
      - backendApps
    restart: unless-stopped
    stop_grace_period: 30s # beri waktu cukup untuk mematikan berbagai layanan
    volumes:
      - /share/open-webui:/app/backend/data
    ports:
      - 3010:8080
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities:
                - gpu
  ollama:
    volumes:
      - /share/ollama:/root/.ollama
    container_name: ollama
    pull_policy: always
    tty: true
    networks:
      - backendApps
    restart: unless-stopped
    image: docker.io/ollama/ollama:latest
    ports:
      - 11434:11434
    environment:
      - OLLAMA_KEEP_ALIVE=24h
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]


networks:
  backendApps:
    external: true
Saya rasa perbedaannya berasal dari sini: OLLAMA_KEEP_ALIVE=24h
Sering memuat dan membongkar model tampaknya menyebabkan masalah. Ketika proses pemuatan berlangsung lama, masalahnya justru jarang terjadi. Secara pribadi, saya sedang menguji dengan durasi 5 jam, dan setelah waktu itu, saya masih mengalami masalah pemuatan—terutama karena model melebihi kapasitas RAM GPU, dan alih-alih beralih ke mode hibrida CPU/GPU, justru beralih ke mode CPU saja. Atau, modelnya dibongkar untuk diganti dengan yang lain.
Masalah ini tidak terbatas pada Open WebUI; masalah yang sama juga terjadi di Qsirch dan RAG.
Sepertinya masalah ini sudah disebutkan di postingan lain, tapi driver Nvidia terbaru memperbaiki beberapa isu seperti ini.
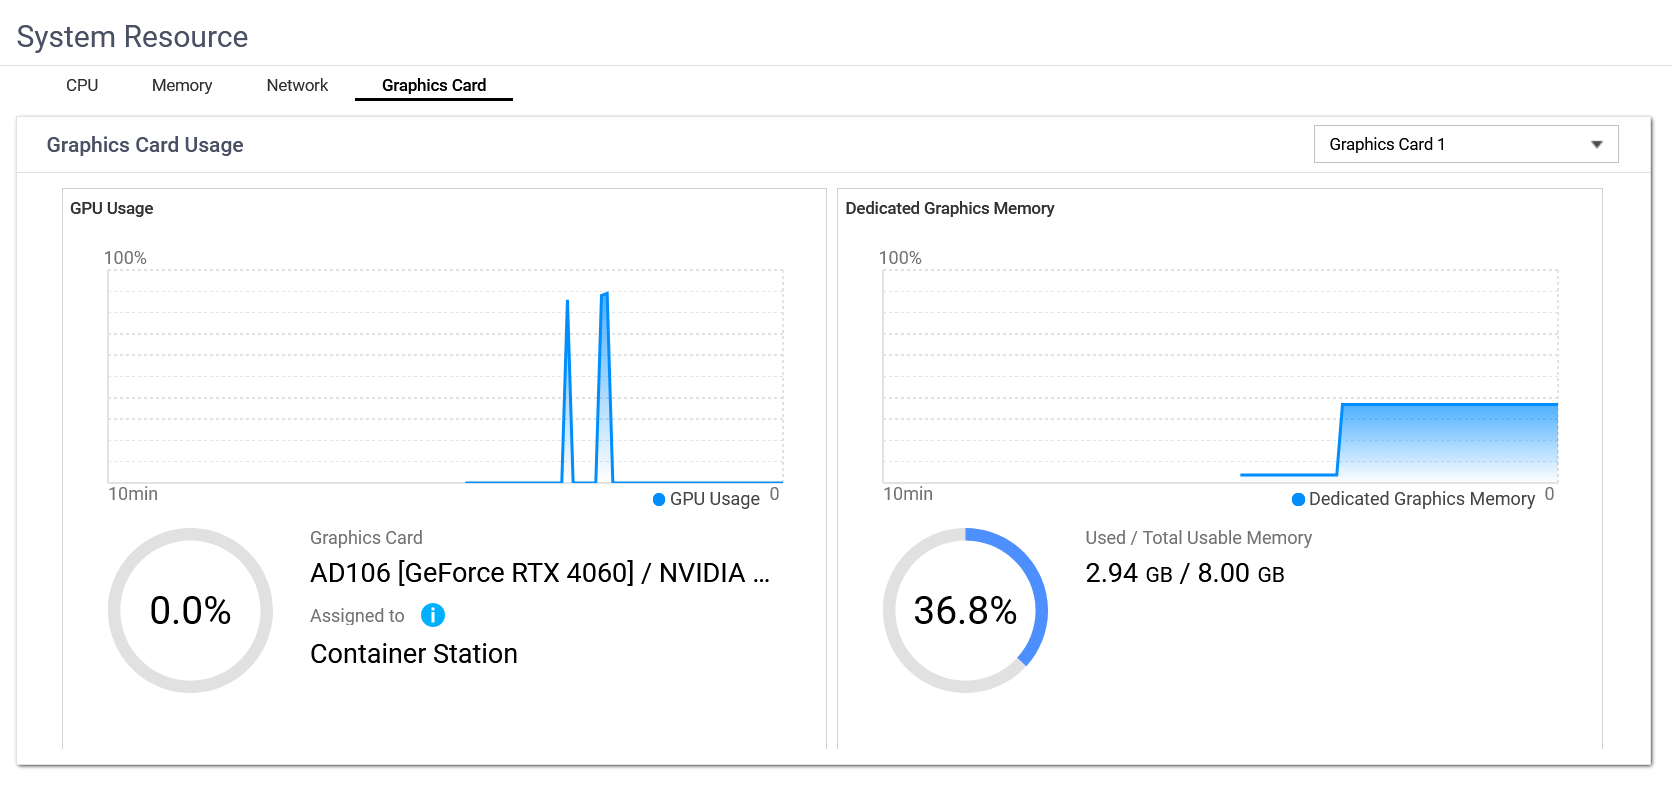
Saya memang mencoba model yang lebih besar yang melebihi 12GB VRAM di kartu saya. Kinerjanya memang melambat, tapi Resource Manager menunjukkan bahwa kartu grafis digunakan sekitar 80% untuk VRAM dan GPU, dibandingkan angka yang lebih kecil saat menggunakan model yang lebih kecil. Tetap saja, prosesnya jauh lebih cepat dibanding saat pertama kali saya mencobanya dan secara default hanya menggunakan CPU saja (yang di Xeon generasi ke-10 sangat lambat).
(Menghapus posting terakhir untuk mencegah kebingungan, karena itu bukan solusinya)
Saya menemukan bahwa konteks CUDA yang dimiliki OLEH proses mana pun dapat mencegah bug ini. Jadi, saya membuat Docker container sederhana dengan Codex: Qnap CUDA holder (GitHub)
Periksa jalur driver dan jalur host kamu, jalankan, lalu tunggu pesan log holding CUDA context. Dalam kasus saya, sekarang saya sudah menggunakan GPU tanpa masalah selama lebih dari seminggu. (Saya sarankan reboot lalu jalankan ini segera; ini tidak ‘memperbaiki’ GPU yang sudah bermasalah).
Hal lain yang perlu diketahui saat mencoba menggunakan GPU Nvidia untuk workload AI. Saya punya tiket yang masih terbuka terkait hal ini dengan QNAP.
Inisialisasi GPU NVIDIA gagal setelah uptime sekitar 1–3 hari — ZFS ARC mem-pin memori fisik; tidak ada blok kontigu 512KB yang tersisa (TVS-AIh1688ATX, QuTS hero h6.0.1.3564)
Pada TVS-AIh1688ATX (192 GB ECC RAM, NVIDIA RTX PRO 4000 Blackwell, driver 575.64.05, BIOS QA008AR14), driver kernel NVIDIA tidak bisa menginisialisasi konteks CUDA setelah sekitar satu hingga tiga hari uptime dengan Arc Ram Usage disetel ke 70%. dmesg menampilkan NVRM “Out of memory [NV_ERR_NO_MEMORY]” dari _memdescAllocInternal saat driver mencoba mengalokasikan MMU fault buffer-nya dengan sekitar 44 GB RAM bebas dan GPU tetap sehat. Kamu bisa memperlambat fragmentasi blok kontigu dengan menurunkan Arc Ram Usage, tapi reboot adalah satu-satunya mekanisme recovery saat ini.
Ini bukan kondisi kehabisan memori. Ini adalah fragmentasi memori fisik: /proc/buddyinfo yang di-capture saat kegagalan menunjukkan zona normal 188 GB dengan nol blok bebas di 128 KB ke atas. Saya memverifikasi kebutuhan driver secara empiris setelah kompaksi paksa memulihkan 18.000+ blok bebas 128 KB dan 69 blok 256 KB; inisialisasi masih gagal sama persis, jadi driver membutuhkan area kontigu minimal 512 KB, dan sistem ini tidak bisa menyediakannya.
Saya telah mencoba semua recovery selain reboot, semua didokumentasikan: menghentikan konsumsi GPU, vm.compact_memory (membangun hingga 256 KB, tembok keras di 512 KB), dan drop_caches penuh diikuti kompaksi (tidak ada kemajuan lebih lanjut). Hal yang menghalangi tiap area 512 KB yang tersisa adalah memori kernel yang tidak bisa dipindah dan tidak bisa diklaim di sistem ini, yaitu ZFS ARC (~127 GB). Hanya reboot yang bisa recover. Dalam workload yang berat di RAM, kegagalan muncul kurang dari 24 jam; pada beban yang lebih ringan, dalam hitungan hari. Reproduksi selalu konsisten.
Hardwarenya sehat: GPU terinisialisasi sempurna tiap kali reboot dan memori lolos MemTest86. Yang saya ingin tahu adalah cara resmi di QuTS hero untuk membatasi ZFS ARC (atau menyisihkan pool kontigu) sehingga sekitar 96–128 GB tetap mendukung kompaksi, atau setidaknya konfirmasi dan pelacakan jika tidak ada parameter untuk itu.
Untuk klarifikasi: Ini kemungkinan besar adalah bug driver yang berasal dari driver Nvidia 575.64(.05), yang saat ini digunakan oleh QNAP. Bahkan jika QNAP mengelola ruang RAM dengan buruk, driver GPU seharusnya tetap dapat menginisialisasi CUDA jika kapasitas RAM cukup, terlepas dari fragmentasi memori, dalam penggunaan normal. Saya kira driver Nvidia 575.64 menerapkan batasan memori yang terlalu ketat atau secara keliru melewatkan jalur fallback untuk alokasi memori.
Namun, selama ada proses yang memegang konteks CUDA, bug ini hilang – karena memori tidak perlu dialokasikan ulang. Itulah alasan saya membuat container sederhana untuk hal ini. (Ada di satu posting di atas) Sekarang saya telah menggunakan CUDA lebih dari seminggu sejak reboot terakhir saya.