Ein Update hierzu. Jemand weiter oben im Thread meinte, dass QuTS Hero 6.0 einen Unterschied gemacht hätte, aber mein erster Versuch war nicht erfolgreich (es wurde immer noch standardmäßig die CPU genutzt). Mit etwas Hilfe von Google Gemini habe ich nun aber ein YAML, das für mich funktioniert.
Hardware: QNAP TVS-h1688x
QuTS Hero: 6.0.0.3500
GPU: Nvidia RTX 3060 (12 GB VRAM)
Docker: Container Station
Mein Ziel war es, Ollama auf meinem 1688x zusammen mit einem OpenWebUI-Frontend laufen zu lassen. Ich habe Google Gemini gebeten, ein passendes YAML zu schreiben, das auf der QNAP Container Station mit Berücksichtigung der RTX 3060 funktioniert. Das war der erste Versuch – und denkt dran, diese Version HAT NICHT mit der GPU funktioniert.
Again, the previous YAML failed to use the GPU. After asking Gemini to rework the issue, it came back with the following YAML that did work with the GPU: (I deleted the OpenWebUI YAML for redundancy since it didn’t change)
I have no idea if this will solve the issue with QTS 5.9.0, but it may be worth a shot. The big difference are the environment variables (OLLAMA_HOST and OLLAMA_KEEP_ALIVE).
Mir ist ein ähnliches Problem wie in diesem Thread beschrieben bisher nicht wirklich aufgefallen. Es kann sein, dass ich es übersehe, da ich open-web AI / die Ollama-App nicht ständig benutze. Ich lasse sie laufen und das LLM wird entladen, beim nächsten Mal wird es dann wieder geladen.
Ich nutze eine zugelassene Nvidia-Karte für mein NAS-Modell.
Ab und zu hatte ich OOM-Killer (Out Of Memory), das habe ich gelöst, indem ich die App gestoppt und wieder neu gestartet habe. Das NAS musste ich nie herunterfahren.
Ich teile die Grafikkarte außerdem mit den Jellyfin- und Immich-Apps.
ich denke, der Unterschied liegt hier: OLLAMA_KEEP_ALIVE=24h
Wenn die Modelle häufig entladen und wieder geladen werden, scheint das Probleme zu verursachen. Wenn der Ladevorgang länger dauert, tritt das Problem anscheinend seltener auf. Ich teste derzeit selbst mit 5 Stunden, und nach dieser Zeit habe ich immer noch das Ladeproblem – hauptsächlich, weil das Modell den GPU-Speicher überschreitet und statt auf einen CPU/GPU-Hybrid-Modus zu wechseln, schaltet es auf reinen CPU-Modus um. Oder das Modell wird entladen, um auf ein anderes zu wechseln.
Das Problem ist nicht auf Open WebUI beschränkt; es trat auch bei Qsirch und RAG auf.
Ich glaube, das wurde schon in anderen Beiträgen erwähnt, aber neuere Nvidia-Treiber beheben einige dieser Probleme.
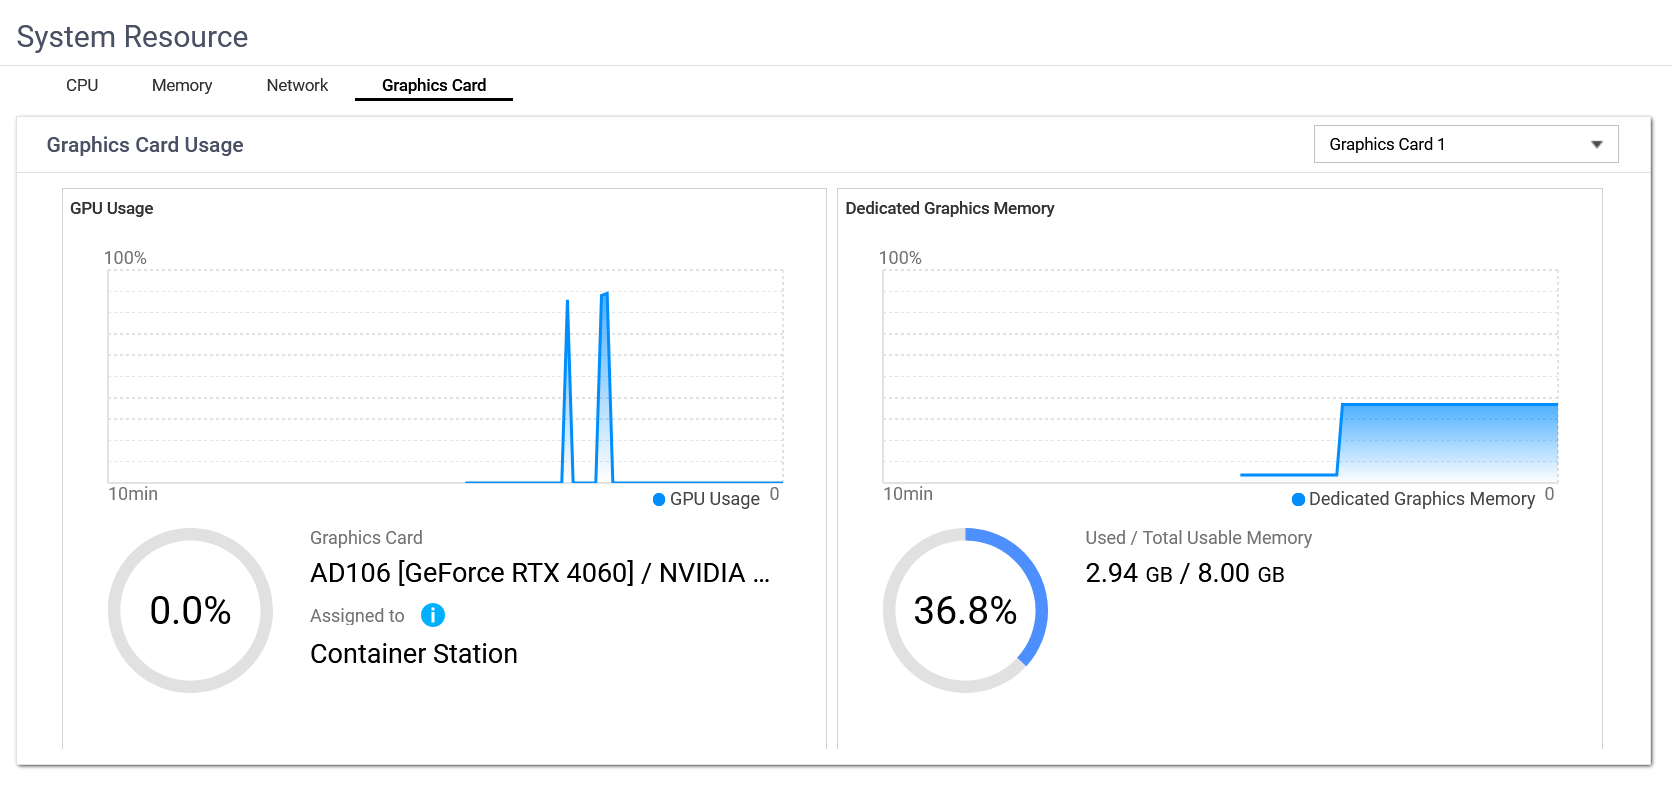
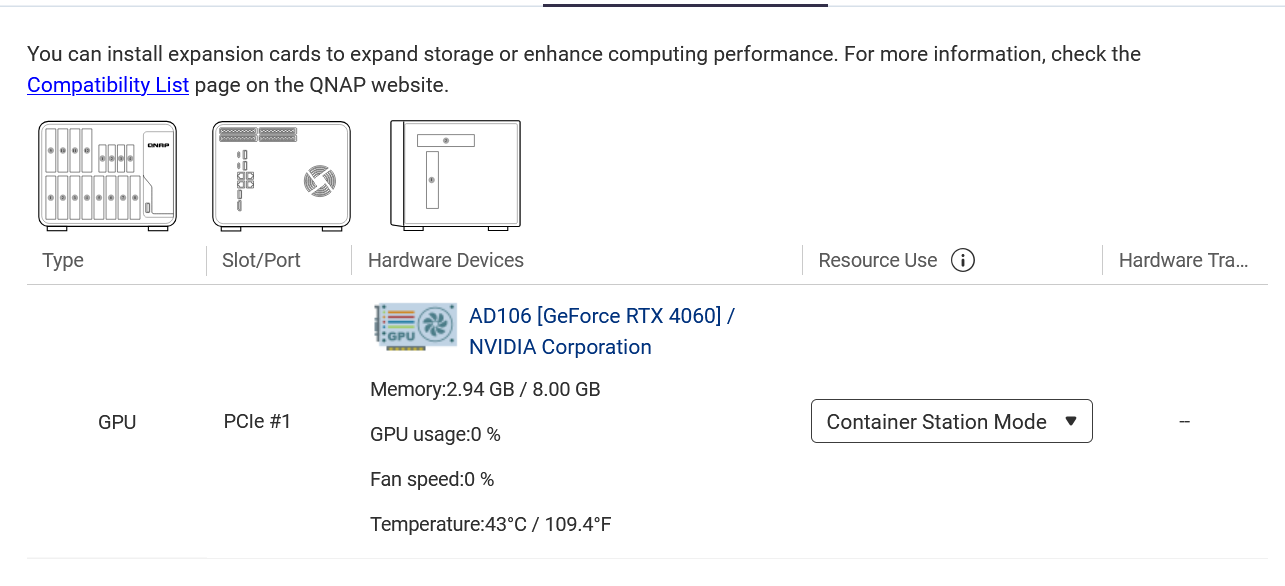
Ich habe tatsächlich ein größeres Modell ausprobiert, das die 12 GB VRAM meiner Karte überschritten hat. Es hat die Verarbeitung zwar verlangsamt, aber der Ressourcenmanager zeigte, dass die Karte etwa zu 80 % beim VRAM und bei der GPU ausgelastet war, im Vergleich zu niedrigeren Werten bei einem kleineren Modell. Es war trotzdem immer noch deutlich schneller als beim ersten Versuch, als alles standardmäßig nur über die CPU lief (und das war auf einem Xeon der 10. Generation extrem langsam).
(Letzten Beitrag gelöscht, um Verwirrungen zu vermeiden, da das nicht die Lösung war)
Ich habe herausgefunden, dass ein von beliebigen Prozessen gehaltener CUDA-Kontext diesen Bug verhindert. Deshalb habe ich diesen einfachen Docker-Container mit Codex erstellt: Qnap CUDA holder (GitHub)
Überprüft den Treiberpfad und euren Host-Pfad, startet ihn und wartet auf die Meldung holding CUDA context im Log. In meinem Fall nutze ich die GPU jetzt seit über einer Woche ohne Probleme. (Empfehle, neu zu starten und das direkt danach auszuführen; es „repariert“ keine bereits fehlerhafte GPU).
Etwas, das du wissen solltest, wenn du Nvidia-GPUs für KI-Workloads einsetzen willst: Ich habe dazu noch ein offenes Ticket bei QNAP.
NVIDIA-GPU-Initialisierung schlägt nach ca. 1–3 Tagen Laufzeit fehl — ZFS ARC fixiert physischen Speicher; keine zusammenhängenden 512-KB-Blöcke bleiben (TVS-AIh1688ATX, QuTS hero h6.0.1.3564)
Auf einem TVS-AIh1688ATX (192 GB ECC RAM, NVIDIA RTX PRO 4000 Blackwell, Treiber 575.64.05, BIOS QA008AR14) kann der NVIDIA-Kernel-Treiber nach etwa ein bis drei Tagen Laufzeit mit auf 70 % gesetzter Arc-Speichernutzung keinen CUDA-Kontext mehr initialisieren. dmesg zeigt NVRM „Out of memory [NV_ERR_NO_MEMORY]“ aus _memdescAllocInternal beim Anlegen des MMU-Fault-Buffers – obwohl ca. 44 GB RAM frei sind und die GPU sonst gesund ist. Du kannst das Schrumpfen zusammenhängender Speicherbereiche hinauszögern, indem du die Arc-Speichernutzung senkst, aber aktuell gibt es nur einen Ausweg: Neustart.
Dies ist kein klassischer Speicherüberlauf, sondern Fragmentierung des physischen Speichers: /proc/buddyinfo zum Zeitpunkt des Fehlers zeigt in der 188-GB-Normalzone null freie Blöcke ab 128 KB aufwärts. Den Bedarf des Treibers habe ich empirisch bestimmt: Nach erzwungener Kompaktion wurden über 18.000 freie 128-KB-Blöcke und 69 256-KB-Blöcke wiederhergestellt; die Initialisierung schlug identisch fehl, also benötigt der Treiber einen zusammenhängenden Bereich von mindestens 512 KB – und das System kann keinen solchen liefern.
Alle Recovery-Optionen bis auf Neustart habe ich ausgeschlossen und dokumentiert: GPU-Consumer stoppen, vm.compact_memory (rekonstruiert bis zu 256 KB, harte Grenze bei 512 KB), und vollständiges drop_caches plus Kompaktion (kein weiterer Fortschritt). Die Seiten, die jeden verbleibenden 512-KB-Bereich blockieren, sind daher auf diesem System unbeweglicher, nicht freigebbarer Kernel-Speicher, ZFS ARC (~127 GB). Nur ein Neustart hilft. Bei RAM-intensiven Workloads tritt der Fehler schon nach weniger als 24 Stunden auf; bei leichterer Last innerhalb von Tagen. Die Reproduktion ist zuverlässig.
Die Hardware ist gesund: Die GPU initialisiert bei jedem frischen Boot problemlos und der Speicher besteht MemTest86. Was ich suche, ist eine offiziell unterstützte Möglichkeit auf QuTS hero, ZFS ARC zu begrenzen (oder einen zusammenhängenden Pool zu reservieren), damit ~96–128 GB kompaktierungsfreundlich bleiben – oder eine Bestätigung und Nachverfolgung, falls es keinen solchen Schalter gibt.
Zur Klarstellung: Das ist höchstwahrscheinlich ein Treiber-Bug, der aus dem Nvidia-Treiber 575.64(.05) stammt, den QNAP derzeit verwendet. Selbst wenn QNAP den RAM schlecht verwaltet, sollte der GPU-Treiber CUDA problemlos initialisieren, wenn genügend RAM-Kapazität vorhanden ist – unabhängig von der Speicherfragmentierung, im normalen Betrieb. Ich vermute, der Nvidia-Treiber 575.64 hat eine zu strenge Einschränkung für den Speicher programmiert oder überspringt fälschlicherweise den Fallback-Mechanismus zur Speicherallokation.
Solange ein beliebiger Prozess eine CUDA-Kontext hält, tritt der Bug nicht auf – denn der Speicher muss dann nicht erneut zugewiesen werden. Daher habe ich einen einfachen Container dafür erstellt. (Siehe einen Beitrag weiter oben.) Mittlerweile nutze ich CUDA nun schon über eine Woche seit meinem letzten Neustart.
Ich hatte die Information, dass der Treiber-Bug in Version 5.2.11 behoben werden würde, und es scheint, dass das jetzt mit NVIDIA GPU Runtime 6.2.3.0580 tatsächlich der Fall ist. Seit dem gestrigen Update läuft alles so, wie es soll. Vorher hielt der Treiber nie länger als ein paar Stunden durch. In der 6.x Beta ist dieser Bug allerdings immer noch vorhanden.