大家好,
我正在嘗試在我的 QNAP NAS 上,透過 Docker 以 GPU 加速方式運行 Ollama,但它總是回退到 CPU。我已經進行了不少除錯,如果有人能提供建議或確認這是不是已知限制,將不勝感激。
 我的環境
-
QTS:5.2.9
-
核心:5.10.60-qnap
-
GPU:NVIDIA GeForce RTX 3090
-
NVIDIA 驅動(QPKG):575.64.05
-
驅動類型:NVIDIA Open Kernel Module(開源核心模組)
-
Docker:Container Station + CLI(--gpus all)
 正常運作的部分
nvidia
nvidia_uvm
nvidia_modeset
nvidia_drm
所以 GPU passthrough(直通)到容器看起來沒問題。
 無法運作的部分
Ollama 無法偵測到 GPU,始終使用 CPU:
inference compute id=cpu library=cpu
total_vram="0 B"
即使 GPU 可用。
 測試過的項目
1. 不同 Ollama 版本
-
0.20.6-rc1
-
0.20.5
-
0.19.0
→ 結果相同(僅用 CPU)
2. CUDA 函式庫
容器內 CUDA 函式庫存在:
/usr/lib/ollama/cuda_v12/libcudart.so.12
/usr/lib/ollama/cuda_v12/libcublas.so.12
/usr/lib/ollama/cuda_v12/libcublasLt.so.12
一開始 ldd 顯示有缺少函式庫,但設定:
LD_LIBRARY_PATH=/usr/lib/ollama:/usr/lib/ollama/cuda_v12:/usr/lib/x86_64-linux-gnu
→ 所有依賴都能正確解析。
3. 仍然失敗
儘管如此,Ollama 在 CUDA 初始化時失敗:
ggml_cuda_init: failed to initialize CUDA: initialization error
4. 核心日誌(這看起來很可疑)
NVRM: nvCheckOkFailedNoLog: Check failed: Out of memory [NV_ERR_NO_MEMORY]
NVRM: faultbufCtrlCmdMmuFaultBufferRegisterNonReplayBuf_IMPL: Error allocating client shadow fault buffer
 我的目前理解
看起來:
由於我用的是 NVIDIA Open Kernel Module(開源核心模組),我懷疑:
 它可能在這個環境下不完全支援 CUDA 工作負載
或是 QNAP 核心(5.10.60)有相容性問題
 問題
-
有沒有人成功在 QNAP 上用 GPU 跑過 Ollama(或其他 CUDA 密集型應用)?
-
這是 NVIDIA Open Kernel Module 在 QNAP 上的已知限制嗎?
-
有沒有可能改用 NVIDIA 專有驅動程式(proprietary driver) 取代開源模組?
-
有人遇過像這樣的 NV_ERR_NO_MEMORY 錯誤嗎?
 臨時解法
目前我考慮:
如果你正在使用 Docker Compose 文件,請在 ollama 部分加入以下內容。
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]
你好,你的意思是:
Docker:Container Station + CLI
nvidia-smi 在主機上運作(透過容器)
===
請按照以下步驟檢查你的問題:
-
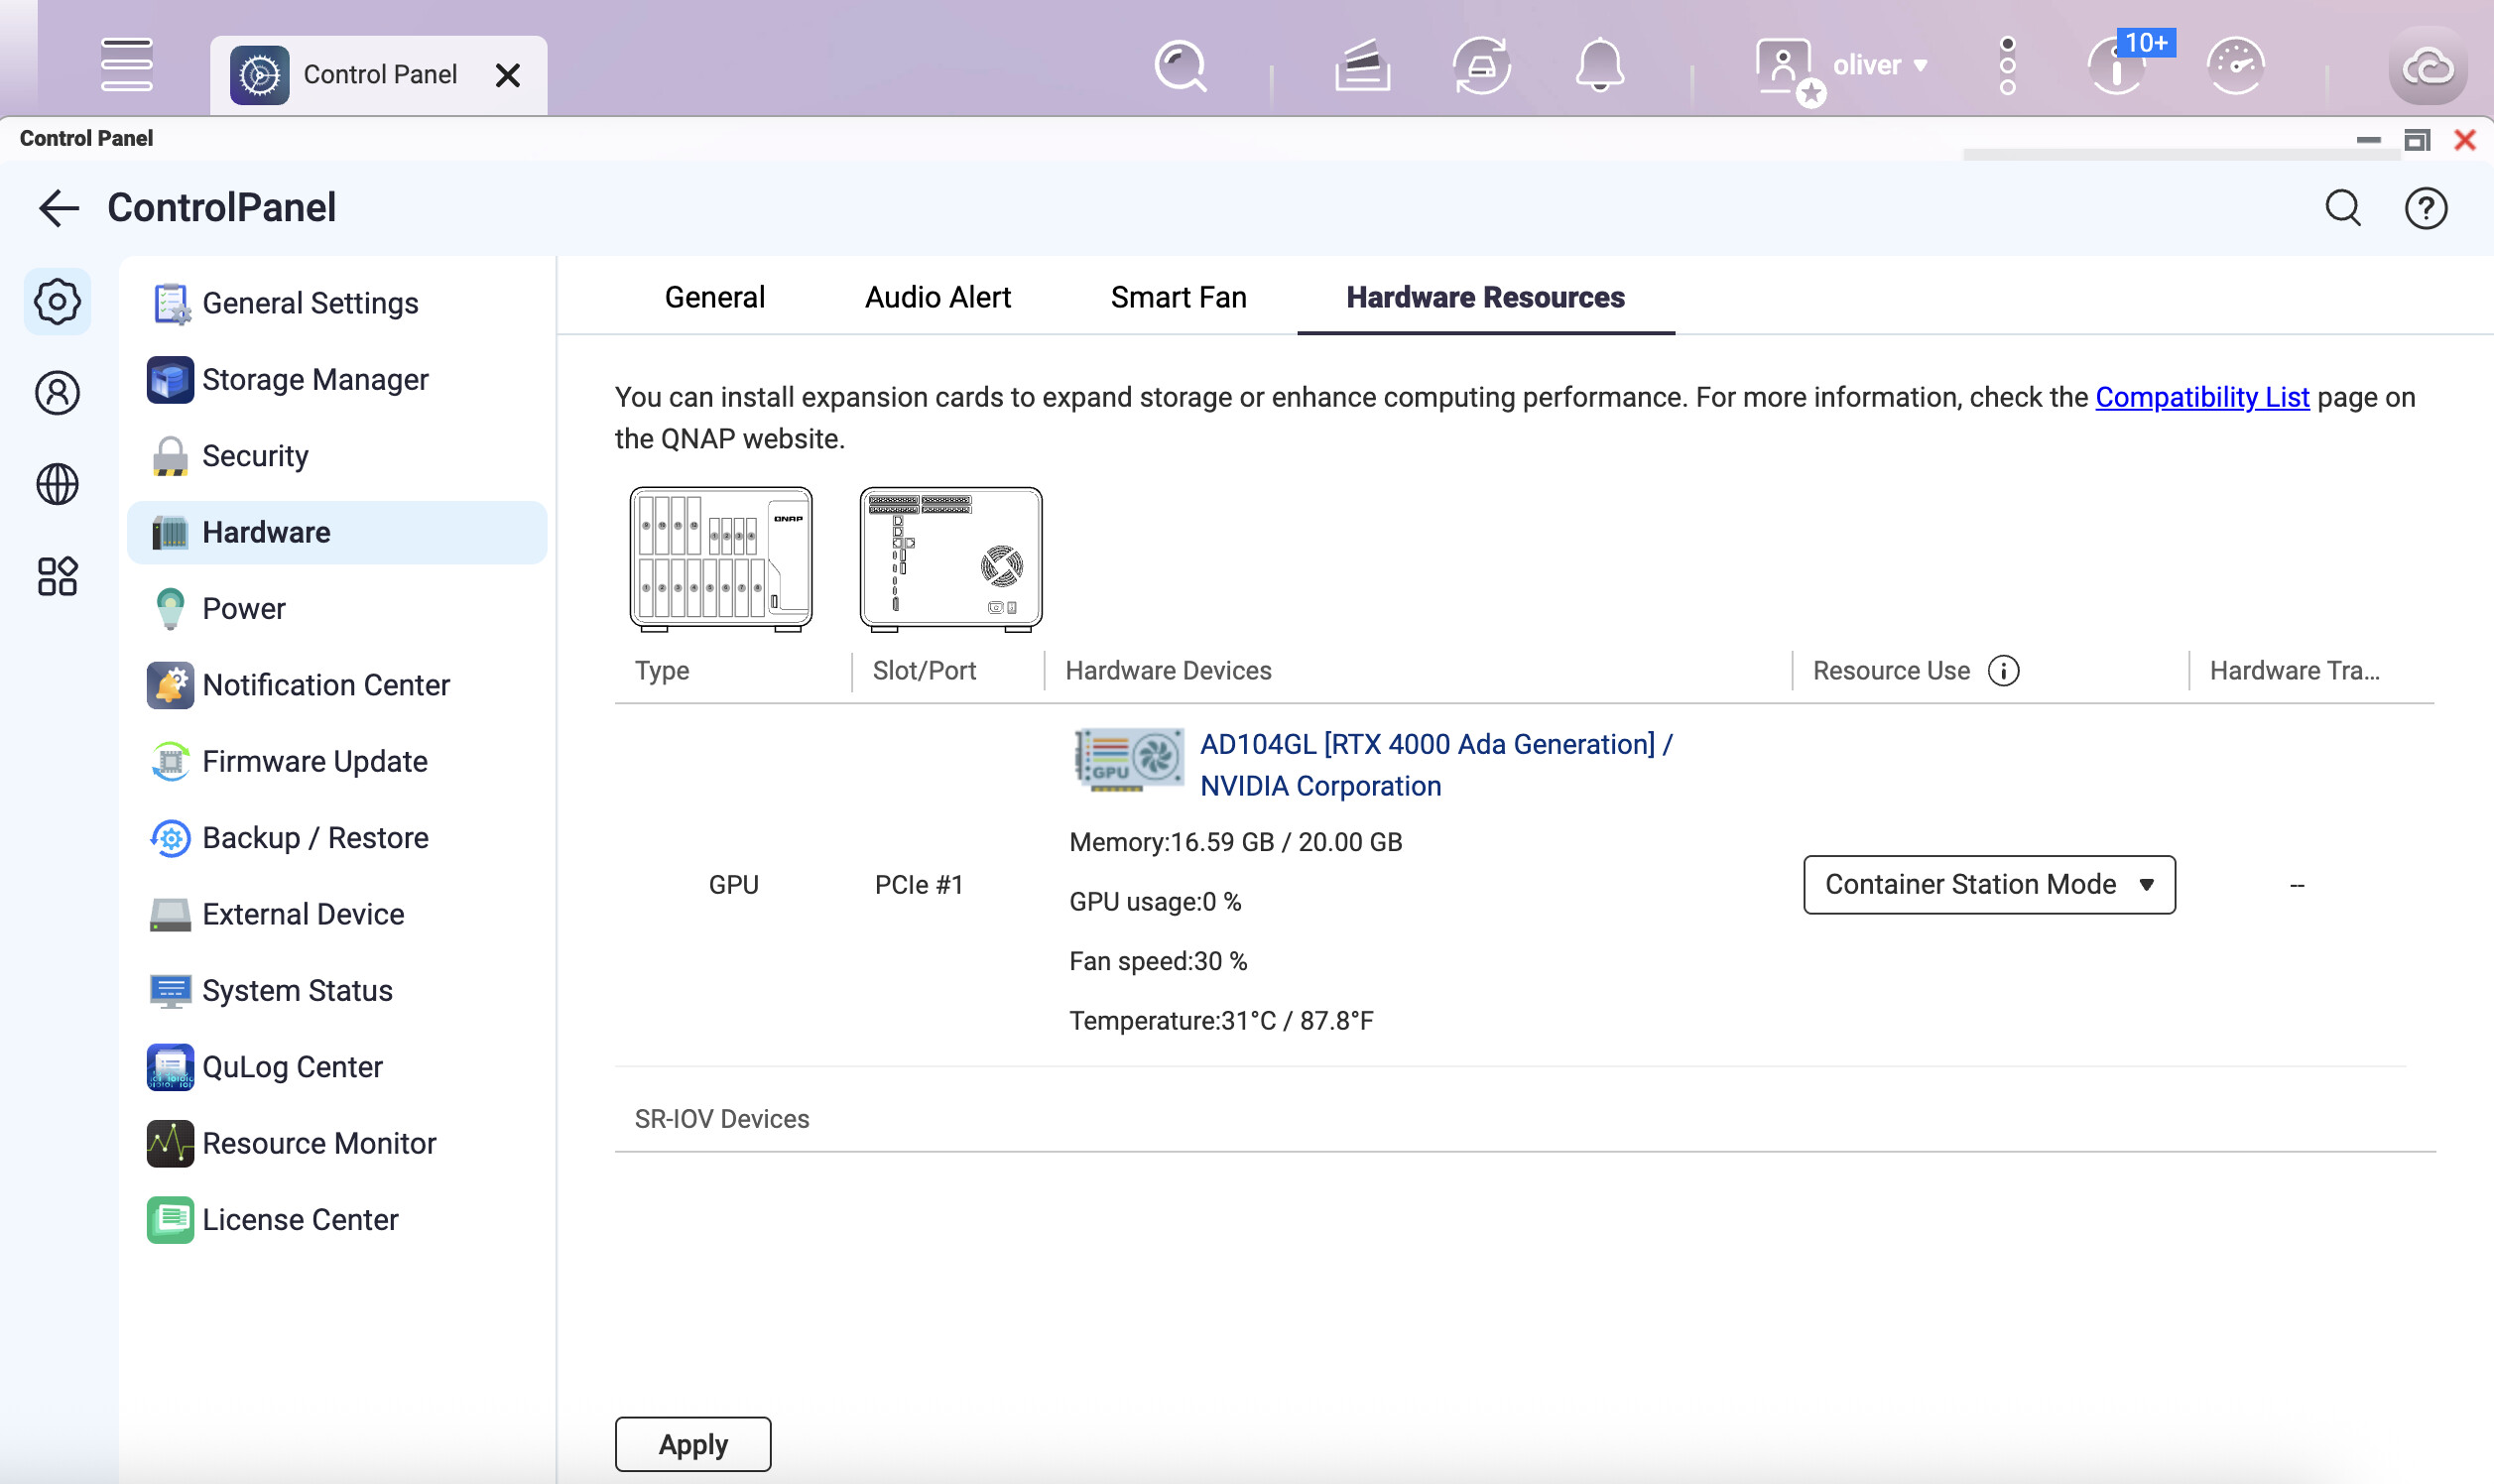
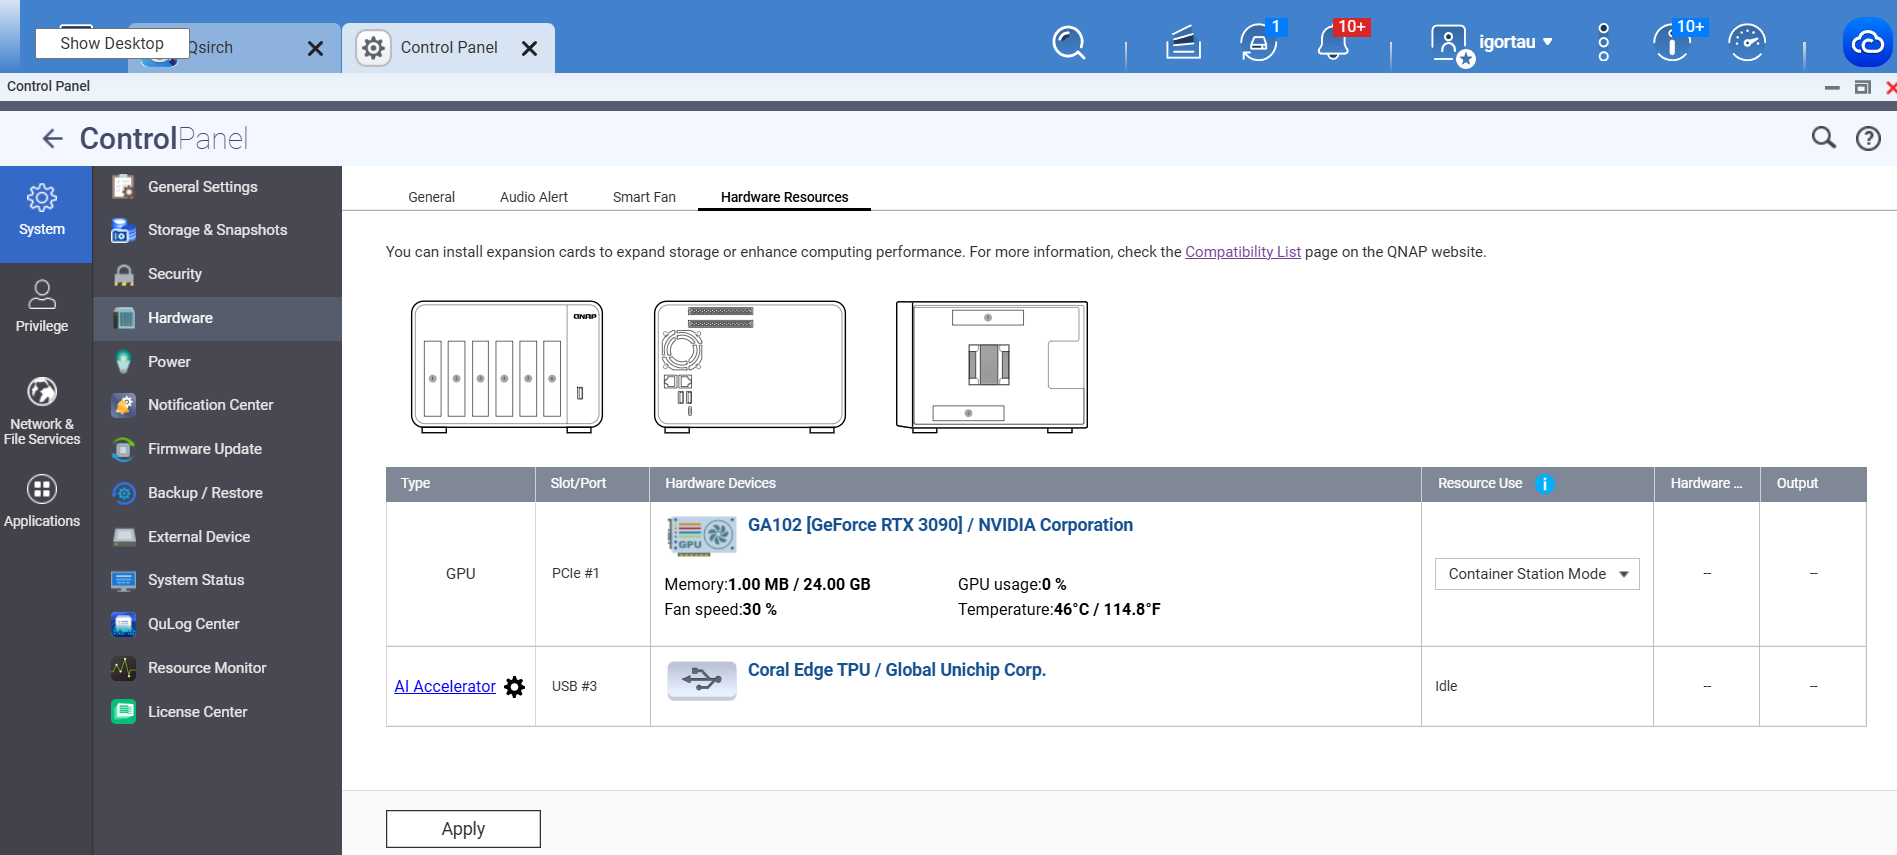
在控制面板中截取 GPU 設定。
-
使用以下 YAML 檔案在 Container Station 中建立一個新應用程式。
services:
  ollama:
    image: ollama/ollama:latest
    volumes:
      - ollama:/root/.ollama
    restart: unless-stopped
    environment:
      - OLLAMA_SCHED_SPREAD=1
    ports:
      - 11434:11434
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]
volumes:
  ollama:
-
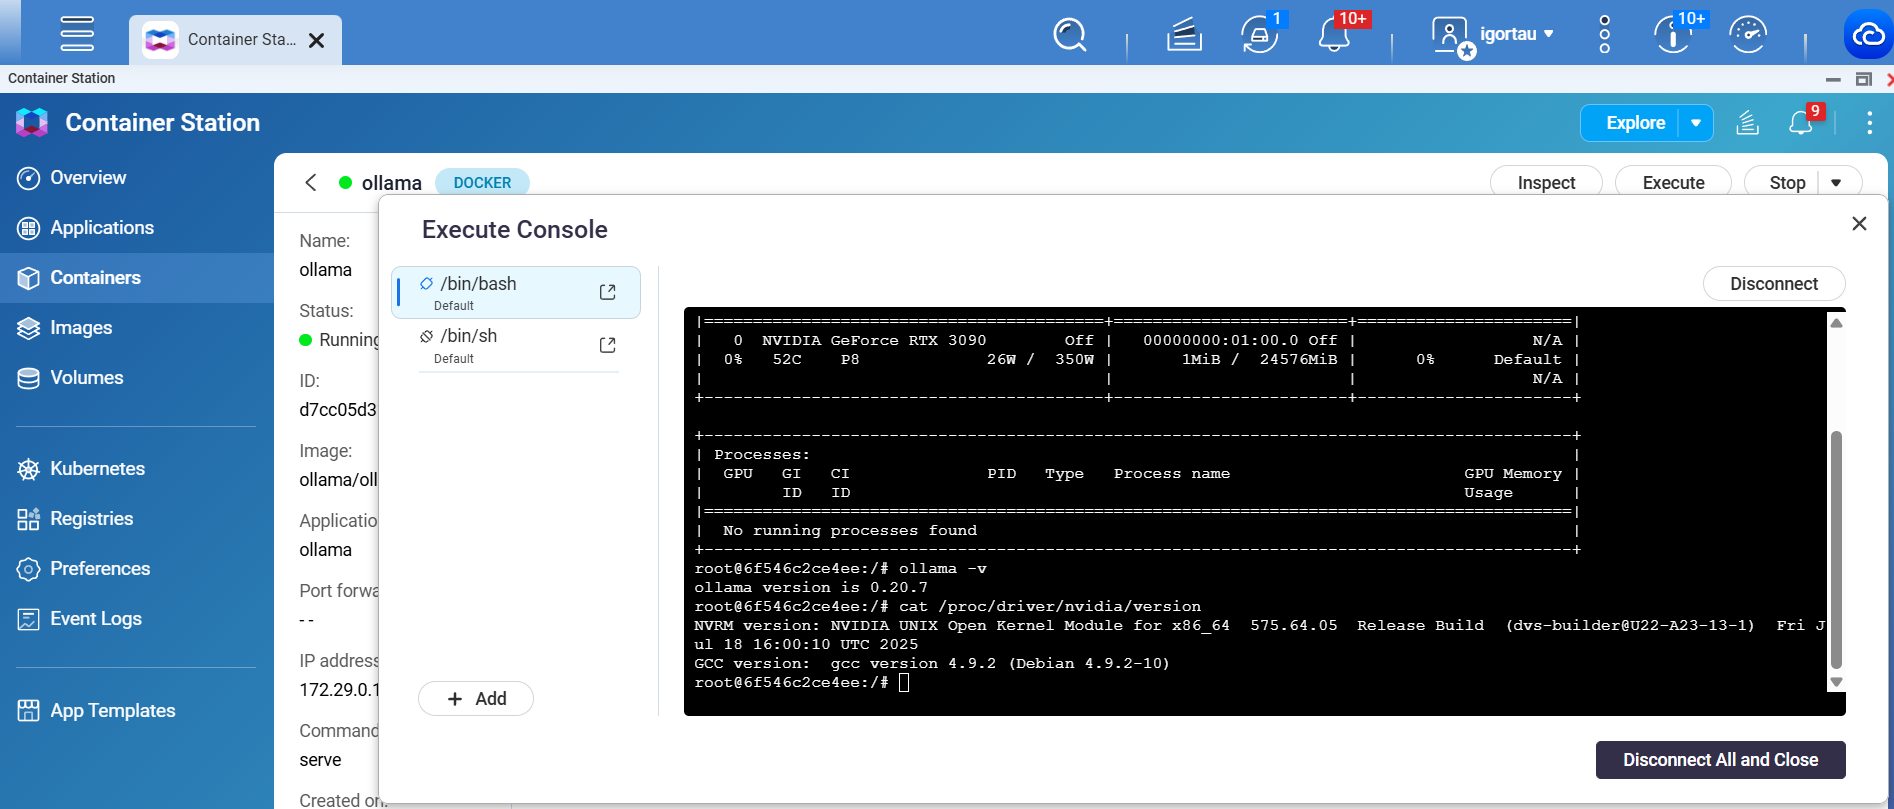
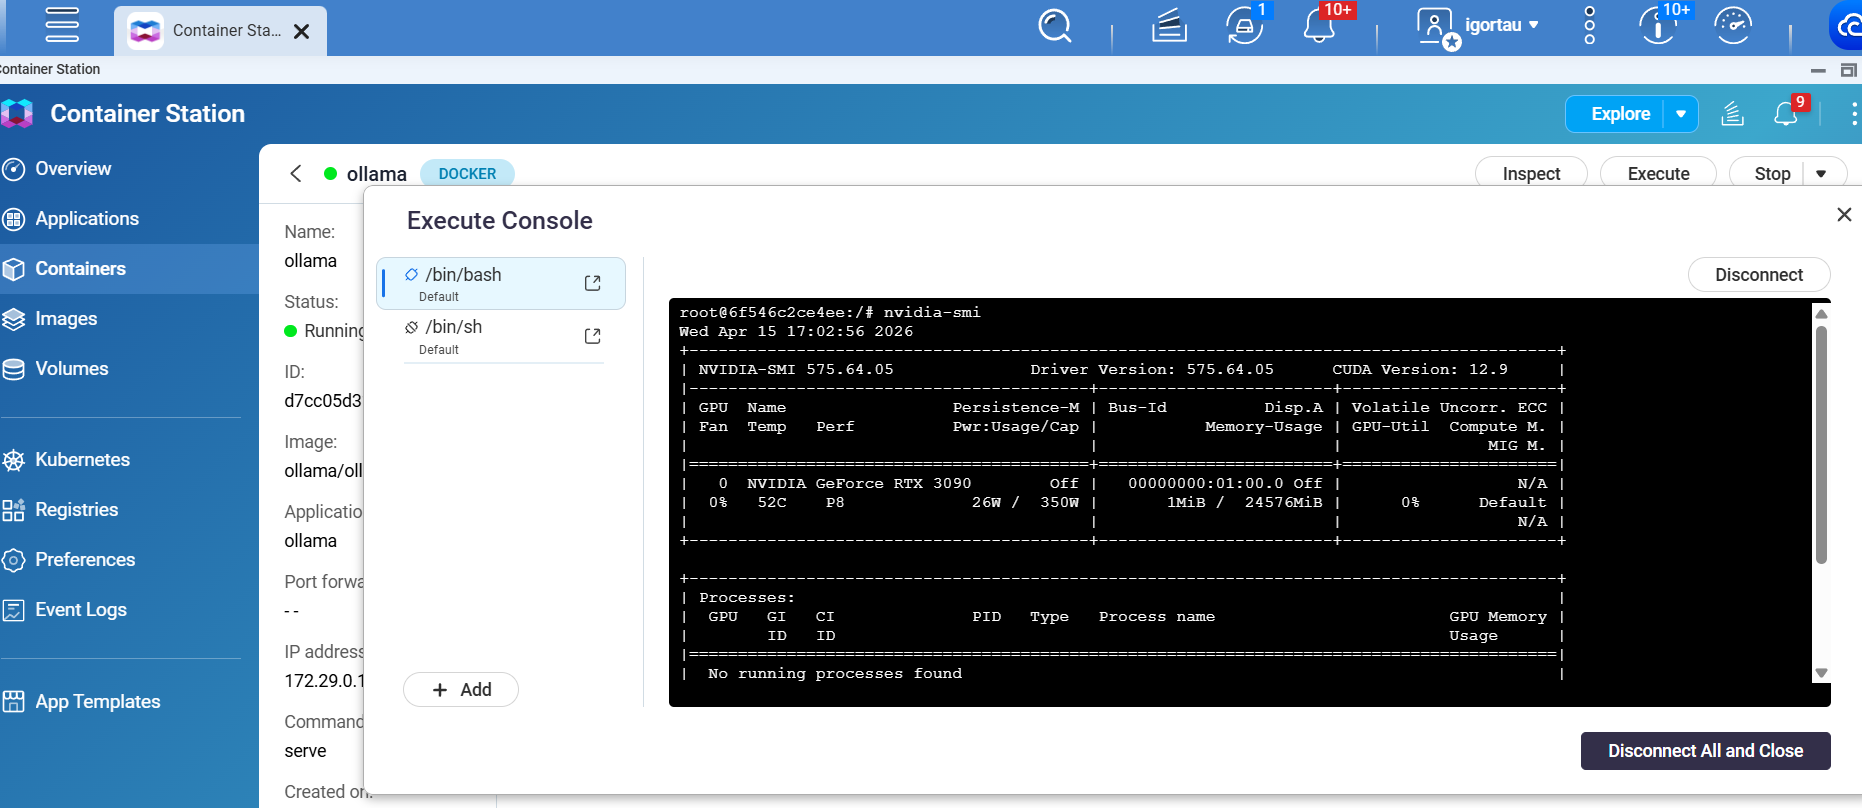
在新的 Ollama 容器中開啟終端機,輸入 nvidia-smi 以檢查是否能偵測到 NVIDIA GPU。
您好,
謝謝。關於:
「Docker:Container Station + CLI」
我的意思是我測試了兩種情況:
另外,說明一下:
nvidia-smi 並不是 QNAP shell 的原生指令,
但在有 GPU 存取權限的 Docker 容器內可以正常運作。
我現在會測試您建議的最小 Container Station 設定,並檢查:
-
容器內的 nvidia-smi
-
Ollama 啟動時是否仍然只偵測到 CPU
我原本的問題是,即使在容器內可以看到 GPU,Ollama 經常回報:
inference compute id=cpu library=cpu
total_vram="0 B"
有時則會出現:
ggml_cuda_init: failed to initialize CUDA: initialization error
我會回報您的 YAML 測試結果。
我們目前懷疑此問題也可能是由驅動程式中的記憶體分配錯誤所引起。我們將針對新驅動程式發布相應的更新。對於由此造成的不便,我們深感抱歉!
對我來說,看起來當我重啟後,ollama + GPU 可以正常使用。但經過一段 GPU 空閒時間後,GPU 在 ollama 裡就無法回應了。有趣的是,這時 GPU 在 QTS 裡變得可見,而且 emby(.qpkg 版本,不是 Container 版本)也能使用它。儘管 GPU 是專門分配給 Container 而不是 QTS 的。
這是怎麼回事?
嘗試後,我也無法在 Container(容器)中存取 GPU,導致無法讓 Ollama 使用 GPU。即使在 Ollama 控制台中 nvidia-smi 可以運作。與 Igorgogi 的設定完全相同。但 Ollama 無法從 GPU 取得可用 VRAM,因此決定使用 CPU。選擇的 LLM 模型非常小。可用 VRAM:12GB
±----------------------------------------------------------------------------------------+
| NVIDIA-SMI 575.64.05 Driver Version: 575.64.05 CUDA Version: 12.9 |
|-----------------------------------------±-----------------------±---------------------+
| GPU Name Persistence-M | Bus-Id Disp.A | Volatile Uncorr. ECC |
| Fan Temp Perf Pwr:Usage/Cap | Memory-Usage | GPU-Util Compute M. |
| | | MIG M. |
|=========================================+========================+======================|
| 0 NVIDIA RTX A2000 12GB Off | 00000000:01:00.0 Off | Off |
| 30% 46C P8 13W / 70W | 1MiB / 12282MiB | 0% Default |
| | | N/A |
±----------------------------------------±-----------------------±---------------------+
±----------------------------------------------------------------------------------------+
| Processes: |
| GPU GI CI PID Type Process name GPU Memory |
| ID ID Usage |
|=========================================================================================|
| No running processes found |
±----------------------------------------------------------------------------------------+
Ollama 日誌:
\033]11;?\033\time=2026-04-18T14:24:46.098Z level=INFO source=routes.go:1752 msg=“server config” env=“map[CUDA_VISIBLE_DEVICES: GGML_VK_VISIBLE_DEVICES: GPU_DEVICE_ORDINAL: HIP_VISIBLE_DEVICES: HSA_OVERRIDE_GFX_VERSION: HTTPS_PROXY: HTTP_PROXY: NO_PROXY: OLLAMA_CONTEXT_LENGTH:0 OLLAMA_DEBUG:INFO OLLAMA_DEBUG_LOG_REQUESTS:false OLLAMA_EDITOR: OLLAMA_FLASH_ATTENTION:false OLLAMA_GPU_OVERHEAD:0 OLLAMA_HOST:xxx OLLAMA_KEEP_ALIVE:5m0s OLLAMA_KV_CACHE_TYPE: OLLAMA_LLM_LIBRARY:cuda OLLAMA_LOAD_TIMEOUT:5m0s OLLAMA_MAX_LOADED_MODELS:0 OLLAMA_MAX_QUEUE:512 OLLAMA_MODELS:/root/.ollama/models OLLAMA_MULTIUSER_CACHE:false OLLAMA_NEW_ENGINE:false OLLAMA_NOHISTORY:false OLLAMA_NOPRUNE:false OLLAMA_NO_CLOUD:false OLLAMA_NUM_PARALLEL:1 OLLAMA_ORIGINS:xxx app://* file://* tauri://* vscode-webview://* vscode-file://*] OLLAMA_REMOTES:[ollama.com] OLLAMA_SCHED_SPREAD:true OLLAMA_VULKAN:false ROCR_VISIBLE_DEVICES: http_proxy: https_proxy: no_proxy:]”
time=2026-04-18T14:24:46.103Z level=INFO source=types.go:60 msg=“inference compute” id=cpu library=cpu compute=“” name=cpu description=cpu libdirs=ollama driver=“” pci_id=“” type=“” total=“31.3 GiB” available=“25.7 GiB”
time=2026-04-18T14:24:46.102Z level=INFO source=routes.go:1810 msg=“Listening on [::]:11434 (version 0.20.7)”
time=2026-04-18T14:24:46.102Z level=INFO source=images.go:506 msg=“total unused blobs removed: 0”
time=2026-04-18T14:24:46.101Z level=INFO source=images.go:499 msg=“total blobs: 25”
time=2026-04-18T14:24:46.103Z level=INFO source=runner.go:67 msg=“discovering available GPUs…”
time=2026-04-18T14:24:46.103Z level=INFO source=routes.go:1860 msg=“vram-based default context” total_vram=“0 B” default_num_ctx=4096
嗨,我可以確認在我的 QNAP 上也遇到非常類似的問題——同樣的驅動、同樣的 QTS,不同的 GPU。
我的配置:
- NAS:QNAP TS-673A - 32GB RAM
- GPU:RTX 3050 OC Low Profile 6G(GA107)
- QTS:5.2.9 / Kernel:5.10.60-qnap
- NVIDIA 驅動:575.64.05(Open Kernel Module)
- CUDA:12.9
- Docker 透過 Container Station,
runtime: nvidia-runtime
使用 GPU 的容器:
- Jellyfin —— NVENC 硬體轉碼
- go-vod —— 用於 Nextcloud Memories 視頻處理的 NVENC
這兩個容器都使用 runtime: nvidia-runtime,並且 NVIDIA_VISIBLE_DEVICES 設定為 GPU 的 UUID,NVIDIA_DRIVER_CAPABILITIES=compute,video,utility。沒有 privileged: true,也沒有手動掛載設備——nvidia-runtime 會自動處理。
可正常運作(至少最初):
- 主機及容器內的
nvidia-smi ✓
- Jellyfin 的 NVENC 硬體編碼 ✓
- go-vod 處理 Nextcloud Memories 時的 NVENC ✓
但經過一段時間未操作,所有 GPU 容器(Jellyfin 和 go-vod)會同時 CUDA 初始化失敗,兩者同時無法運作。唯一可靠的解決方法是整台 NAS 重開機,單純重啟容器無效。
我已試過所有能找到的方法:
nvidia-smi -pm 1(啟用持久性模式)——沒成效privileged: true——導致啟動出現問題- 手動掛載設備——沒成效
- docker.json 改用
cgroupfs driver——略有改善
我已經向 QNAP 送出支援票快一個月了,收到的唯一回覆是「他們正在處理中」——沒有時程、沒有解法、也沒有任何具體資訊。這個問題明明很容易重現,影響多款 GPU 的多位用戶,在不同的討論串裡都有人遇到,這樣的處理真的非常令人沮喪。
在 QNAP 釋出驅動修正前的暫時解決方案
我也遇到相同的問題,真的快被搞瘋了!Ollama 和 Open WebUI 是跑在 Container Station 裡面,顯卡直通使用 RTX 3060 12GB。每次 Ollama 用完進入閒置狀態後,就會自動切回 CPU,雖然用 nvidia-smi 還是可以看到 GPU 顯示正常,但就是怎樣都沒辦法讓 GPU 恢復工作,只能重啟容器才行。
最後我把 Ollama 移到 NVME 上,目前一切都運作得很順利——就算快速切換模型,新模型也能直接加載到 GPU,反應幾乎是瞬間的。當 Ollama 進入閒置時,GPU 也會正常卸載,等我一開啟聊天室 GPU 又馬上啟動,所有功能都能即時運作。就我的經驗來看,Ollama 安裝在 NAS 內的 HDD(Ironwolf)太慢,導致 GPU 無法正常運作,才會自動換回用 CPU。
希望這個解法能暫時幫到有遇到相同問題的人!
你好,
我也遇到和你一樣的問題(RTX Pro 4000 Blackwell),無論是在 Qsirch 的 RAG 還是在 Ollama 容器中,都會發生。常常會不定時(發生的等待時間不固定),模型會跑到使用 CPU 而不是 GPU。我也有提交支援單(還在等回覆)。
我這幾天才開始接觸 Ollama,已經慢慢學會一些基本指令,但還是不明白問題到底出在哪裡。
我的所有應用程式、容器和模型也都是在 RAID SSD 上執行的。
我的容器一直都是放在 SSD 上,所以這個方法不適合我。我已經開了一個工單一個月了,到目前為止只收到他們回覆說正在處理中。我又補充了更多資訊,但至今還是沒有收到回應。
7.5. 的回覆是…
你好
感謝你的回覆,請耐心等候,我們的開發團隊需要一些時間來處理這個問題。
目前我們的開發團隊還在處理中。
有任何進一步的回饋,我會立即通知你。謝謝。
自從一月左右推出需要手動重新安裝 Nvidia 驅動程式的韌體更新後,我就一直遇到同樣的問題。我已開立 Q-202606-32810,為了解決這個問題,提供額外的日誌或其他資源,因為每當從 CUDA 回退時,CPU 佔用率100%,已經開始影響我的工作流程。
我可以確認,升級到 QuTS Hero 6.0(以及隨附的 NvKernel 驅動程式更新)解決了我的問題。我合作的人能夠用 OCR 處理約兩百萬個資產,然後終止處理程序讓 GPU 進入閒置狀態,接著切換模型並在週末無任何問題地執行了數個其他工作。本週一早上,在大約 18 小時未執行任何作業後,任務再次啟動,並且模型載入時也沒有再出現 GPU 錯誤。
唉,就我而言,在我第一次發文時,我就已經在使用 QuTS Hero 6 的 beta 版本了,並配上了最新的驅動程序,後來轉到正式版也沒有任何改變。我的系統還是一樣會從 GPU 轉回 CPU。不過,我確實有感受到「變好」了一些,這或許是因為模型端的記憶體溢位所造成的。我會在接下來的幾天持續觀察這個狀況。
注意:我的支援單已經在沒有任何支援的情況下被關閉了。
我找到答案了,請見下文。一開始我嘗試了這個方法,但似乎沒什麼幫助。我必須重新啟動NAS,結果還是不行,情況甚至更糟,系統無法使用顯示卡。然後我重新安裝了 NvKernelDriver,一切才開始正常運作。到現在已經5個小時,一切都很正常。明天早上再看看狀況……
嗨
我們的開發團隊提供了一個暫時的解決方法
請透過 SSH 連線到 NAS,並執行以下指令:
# sync; echo 3 > /proc/sys/vm/drop_caches
然後重新啟動應用程式。如果問題依舊,完整重開機應該就能解決。
謝謝。
幾個小時後問題又出現了,所以這甚至稱不上是暫時的解決方法。
我們都需要持續向 Qnap 反映這個問題,這真的讓人很沮喪,不只我,這個論壇上很多人都有同樣困擾。
如果有人急需暫時的解決方法,我發現用 Home Assistant 每 4 分鐘 ping 一次 ollama 對話代理可以解決這個問題。自從我這麼做了之後,CPU 再也沒有出現異常飆升,也沒有出現模型從 GPU 離線的情況。
如果你安裝了 Home Assistant,並且有對話代理,這個自動化暫時能用來解決問題:
alias: Ollama QNAP GPU 保持連線
description: 每 4 分鐘 ping 一次 Extended OpenAI Conversation,避免 QTS CUDA 掉線
triggers:
- minutes: /4
trigger: time_pattern
actions:
- action: conversation.process
data:
agent_id: conversation.extended_openai_conversation
text: ping
mode: single
我懷疑這個問題是由於NVIDIA 有問題的驅動與 QNAP 特製驅動組合造成的。
這是我目前的經歷。我手上的是 RTX 3050 6GB LP,這正是 TS-473A 官方兼容列表上的型號。
- 裝置剛重啟時,用 GPU 加速執行容器一切正常。
- 但在連續運作 24-48 小時後(實際時間會有變動),GPU 加速初始化就開始失敗。查
dmesg,會看到一堆 NVRM: nvCheckOkFailedNoLog: Check failed: Out of memory [NV_ERR_NO_MEMORY] 的錯誤。
- 執行
sudo sh -c 'sync; echo 3 > /proc/sys/vm/drop_caches' 沒有用。查 meminfo,前後也沒差異。
其實這問題不是出在 VRAM 或 GPU 本身。驅動會要求一種特定型態的系統 RAM 配置,但目前驅動程式因某個 bug 而分配失敗。
我在研究的時候,也在其他論壇看到過類似的 bug 回報,都大約是一年前的帖子。
(注意:千萬不要執行 /proc/sys/vm/compact_memory。 這會觸發 kernel bug,造成系統不穩,必須重新開機才能處理。這是另外一個 OpenZFS 的 kernel bug,QNAP 自己修不了,必須由 ZFS 原廠修正。)
所以我不認為這完全是 QNAP 的責任……(雖然說起來真的很令人沮喪;QNAP 現在大力宣傳自家 AI NAS 產品,但這問題根本讓使用者難以順利跑 AI……拜託快點修好。)
目前我能想到的唯一暫時解法,就是剛開機後立馬讓你的 GPU 處理程序/容器等跑起來,並且讓這個程式持續佔用 GPU 盡量不要釋放——這樣就不用重新初始化。這個 bug 只會在初始化(精確來說是在 RAM 配置階段)時才發生,不會影響已經在運作、已經佔用 RAM/GPU 的程序。(這也是為什麼每 4 分鐘 ping 一次 Ollama 有效的原因。)