質問があります。もしかするとQNAPのスタッフに答えてもらう必要があるかもしれません。
QsirchでオンプレミスのLLMやRAG検索を試してみたいと思っています。しかし、私のNASにはGPUが搭載されていません。QNAPのUSB AI Acceleratorデバイスは持っています。
QNAPのウェブサイトには、GPUが必要だとは書かれていません:
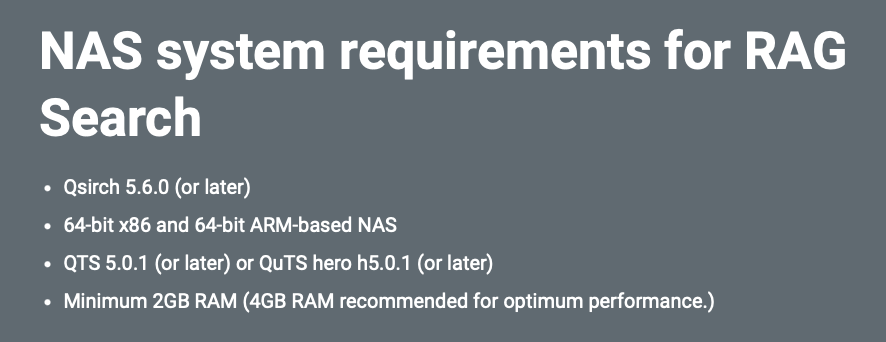
ですが、実際には必要なようです。なぜGPUの代わりにAIアクセラレーターを使うことはできないのでしょうか?
質問があります。もしかするとQNAPのスタッフに答えてもらう必要があるかもしれません。
QsirchでオンプレミスのLLMやRAG検索を試してみたいと思っています。しかし、私のNASにはGPUが搭載されていません。QNAPのUSB AI Acceleratorデバイスは持っています。
QNAPのウェブサイトには、GPUが必要だとは書かれていません:
ですが、実際には必要なようです。なぜGPUの代わりにAIアクセラレーターを使うことはできないのでしょうか?
オンプレミスRAG検索は、最初の検索時にLLM(大規模言語モデル)をビデオメモリにロードします。GPUメモリが不足している場合、不足エラー(insufficient memory)が報告されます。
最低要件は明記されていませんが、「推奨」要件はこちらに記載されています:
How to Set up On-Prem Qsirch RAG | QNAP
推奨されているのはRTX 4000(Ada世代、vRAM 20GB)とRTX 6000 Pro(同じくAda世代、vRAM 96GB)です。試しにRTX 3050 6GBでいくつかの小型モデルをロードできましたが、多くはロードできませんでした。パフォーマンスは、同等のデスクトップでollamaを実行するのと似ています。
「AI Accelerator」についてですが、この種のタスクに必要なメモリはないのではと推測しますが、その点はQNAPが説明・対応するのが良いでしょう。
補足として、RAG検索機能では常にオンラインLLMも利用できますが、その場合NASからGeminiやChatGPTなどにデータが送信され、完全なオンプレミスにはなりません。GPUは不要で、すべての処理はクラウドプロバイダーのデータセンターで行われます。
ご参考になれば幸いです。
なるほど。そうですね、ここで重要なのはおそらくメモリでしょう。アクセラレータにはおそらく十分なメモリがないという点には同意します。
自分の10ギガビットファイバーを手放して、このTS-873Aにうまく動作するかどうかわからないGPUを入れるつもりはありません。そこまでの価値はないですね。
それに、自分の検索を外部に出したくありません。そういうことなら、普通にそのウェブサイトにアクセスすれば済むことですから…
Qsirch RAG Search にご関心をお寄せいただきありがとうございます。
現時点では、Qsirch をオンプレミスの LLM + RAG サーチで実行する場合、NVIDIA GPU が必要です。主な理由は、ローカルの LLM を正常に動作させるにはかなりの GPU メモリが必要であり、AI Accelerator ではまだ十分に対応できないためです。
データプライバシーを重視し、データをローカルに保ちたいというご要望はよく理解しています。それは全く理にかなっています。
ただし、評価目的でクラウド LLM を使った RAG サーチをお試しいただける場合、Qsirch で RAG がどのように機能するかや、OpenAI 互換 API の設定方法を把握する良い方法になります。
まずは小規模または機密性の低いデータセットでワークフローを理解し、その後すべてをオンプレミスの GPU で運用するかどうかをご検討いただくのもおすすめです。
ありがとう、Vivian。LLMの検索機能は特に必要ありませんでした。本当